Fableに最も似ているモデルはOpusではない。Sonnetでもない。
@DawidGalarowicz と @petergostev による
Arenaのバトルモードでは、同じユーザープロンプトに答える2つのモデルを比較できる。これにより、選好だけでなく、両者がどれだけ概念的領域を共有しているかも測定できる。
私たちは、5月1日から9月2日の間に投稿された同じ実世界のテキストアリーナのプロンプトに対する30,086組のAI回答を検討した。モデル同士がどれほど似ているかについて、分かったことは次のとおりである。
主な調査結果
・異なるLLMは異なる領域を扱う。モデル同士が共有していたアイデアはわずか43.1%だった。
・同じモデルファミリーの隣接世代は互いに似通う。Grok 4.5とGrok 4.6はアイデアの59.7%を共有し、GPT 5.5とGPT 5.6は59.2%を共有した。
・米国と中国のモデルは同じアイデアを参照する。Fable 5とGLM 5.3は論点の55.9%を共有し、GLM、Kimi、Opus、Sonnetはより重なりの大きい近傍を形成した。
・高いトークン価格を払っても異なる視点は買えない。Fable 5とDeepSeek V4 Proは12倍の価格差があったが、アイデアの59.2%を共有していた。
・モデルは思考の仕方において収斂しつつある。最近のリリースの多くは、以前のバージョンよりも頻繁に同じアイデアを扱うように見える。
モデルの出力は想像以上に多様
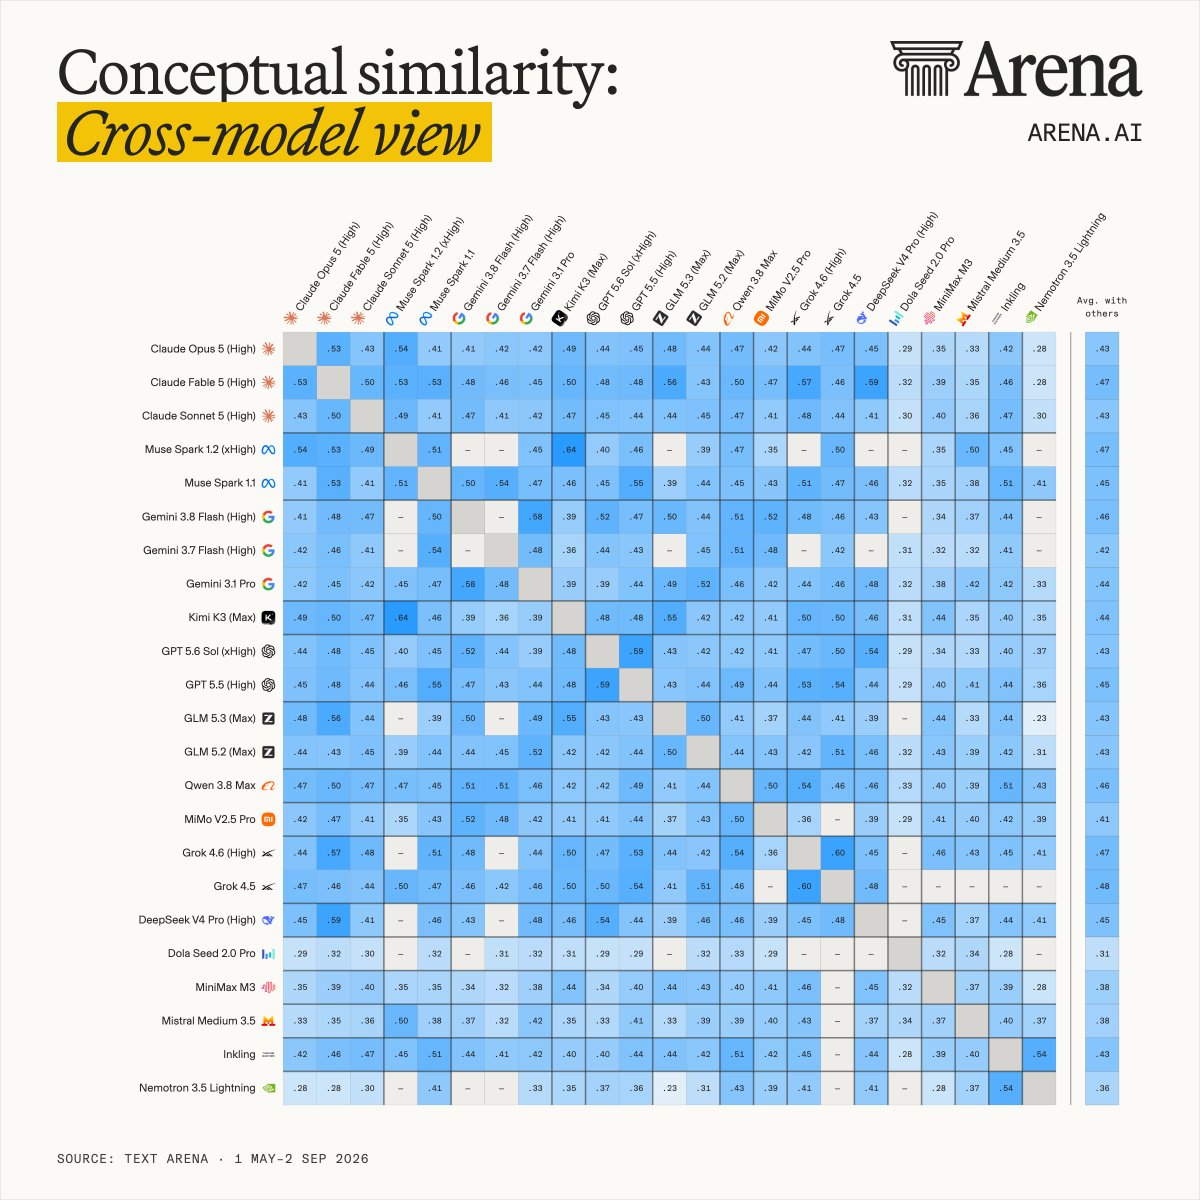
モデル応答の内容がどれほど似ているかを捉えるため、私たちは「概念的類似度」と呼ぶ指標を定義した。このアプローチは、ユーザーとAIのやり取りを、同じクエリに対して2つの別々のLLMが示した5つの主要な論点に要約し、その結果得られる10の論点間の重なりを推定した。
平均して、1つのバトル内で特定された異なる論点の約4割が両方の応答に現れた。最先端モデルが類似した訓練レシピに従っているにもかかわらず、それらが利用可能なアイデアの異なる部分集合を日常的に選んでいることが分かる。
たとえば、パンケーキのレシピを求められたとき、2つのモデルが同じ手順を扱っても、一方はトッピングの提案を選び、他方は避けるべき失敗を含めるかもしれない。
この差は隣接するモデル世代の間では小さくなる。それらはしばしば限られたセカンドオピニオンしかもたらさない。Grok 4.5とGrok 4.6はアイデアの59.7%を共有し、GPT 5.5とGPT 5.6は59.2%を共有した。これらの組み合わせは検証を目的とする場合には有用かもしれないが、概念的範囲は比較的小さい。
観測された中で最も高い重なりはKimi K3とMuse Spark 1.2の間で63.5%だった。反対の極端では、バイトダンスのDola Seed 2.0 Proが特に差別化されており、観測された組み合わせ全体で平均約31.1%だった。
米国と中国のモデルは同じように考える
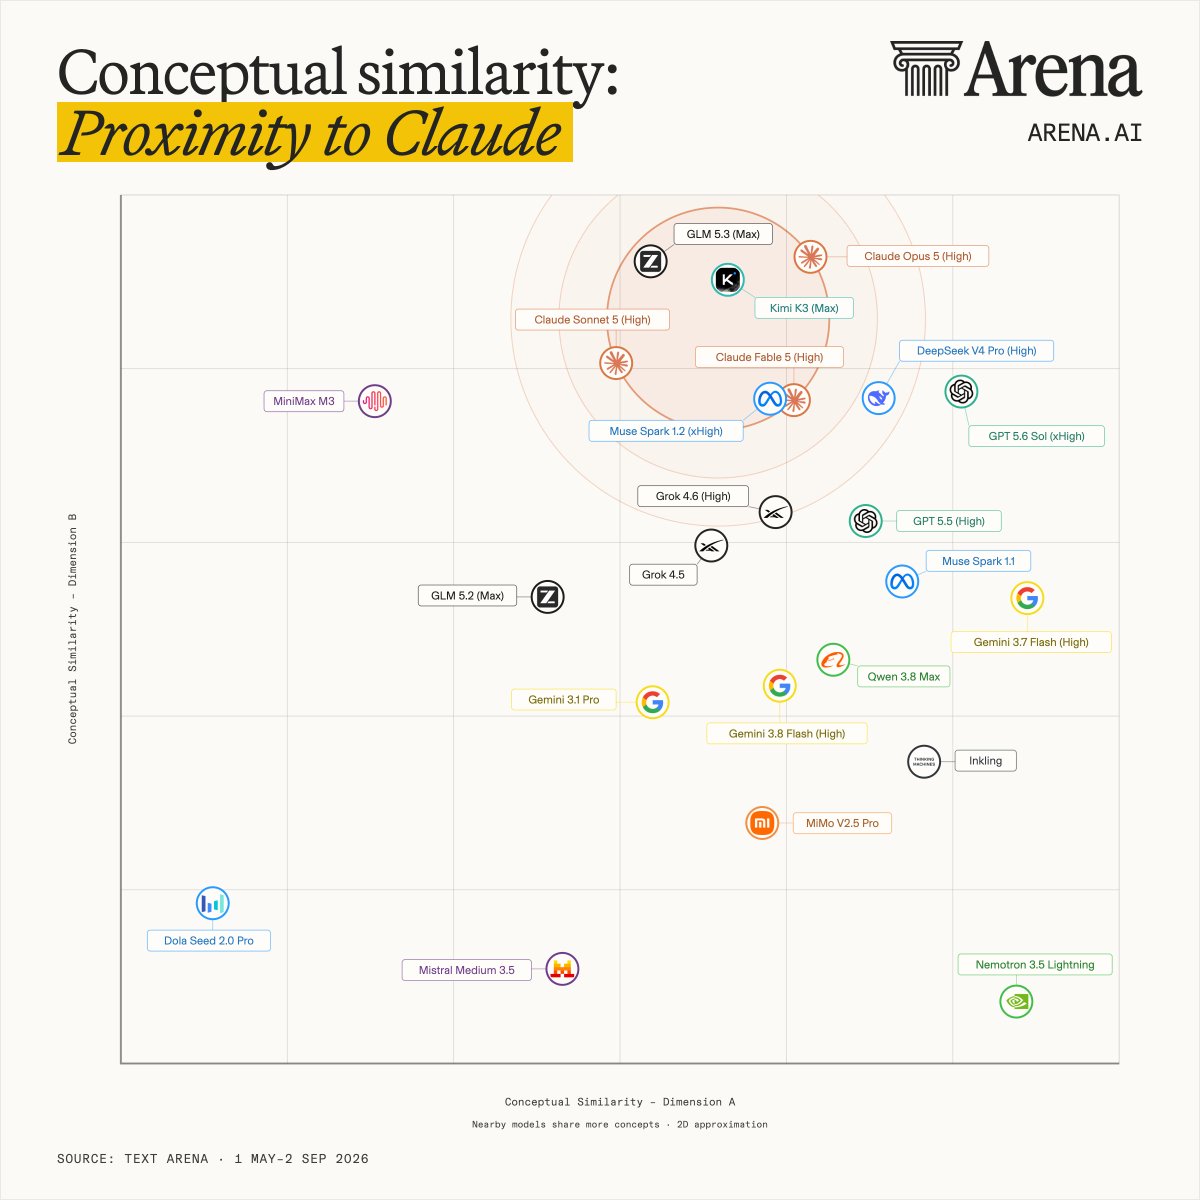
同じラボからリリースされたモデル間の関係がより密接であることを考えると、米国内からのリリース同士の方が国外のものよりも強い結びつきを示すと予想してもおかしくない。
しかし、モデルの類似性は国境を越えることが分かる。GLM、Kimi、Opus、Sonnetは、孤立した米国陣営と中国陣営を形成するのではなく、同じ高重なり近傍を占めている。これは、3つのClaudeモデルとの重なりを重ね合わせると特に明確になる。
この具体的な理由を突き止めるのは難しいが、最先端における概念的類似性は、モデルが中核的な訓練資料を共有していることと、最近のラボ横断的な焦点から単純に生じている可能性がある。
モデルの重なりは増大している
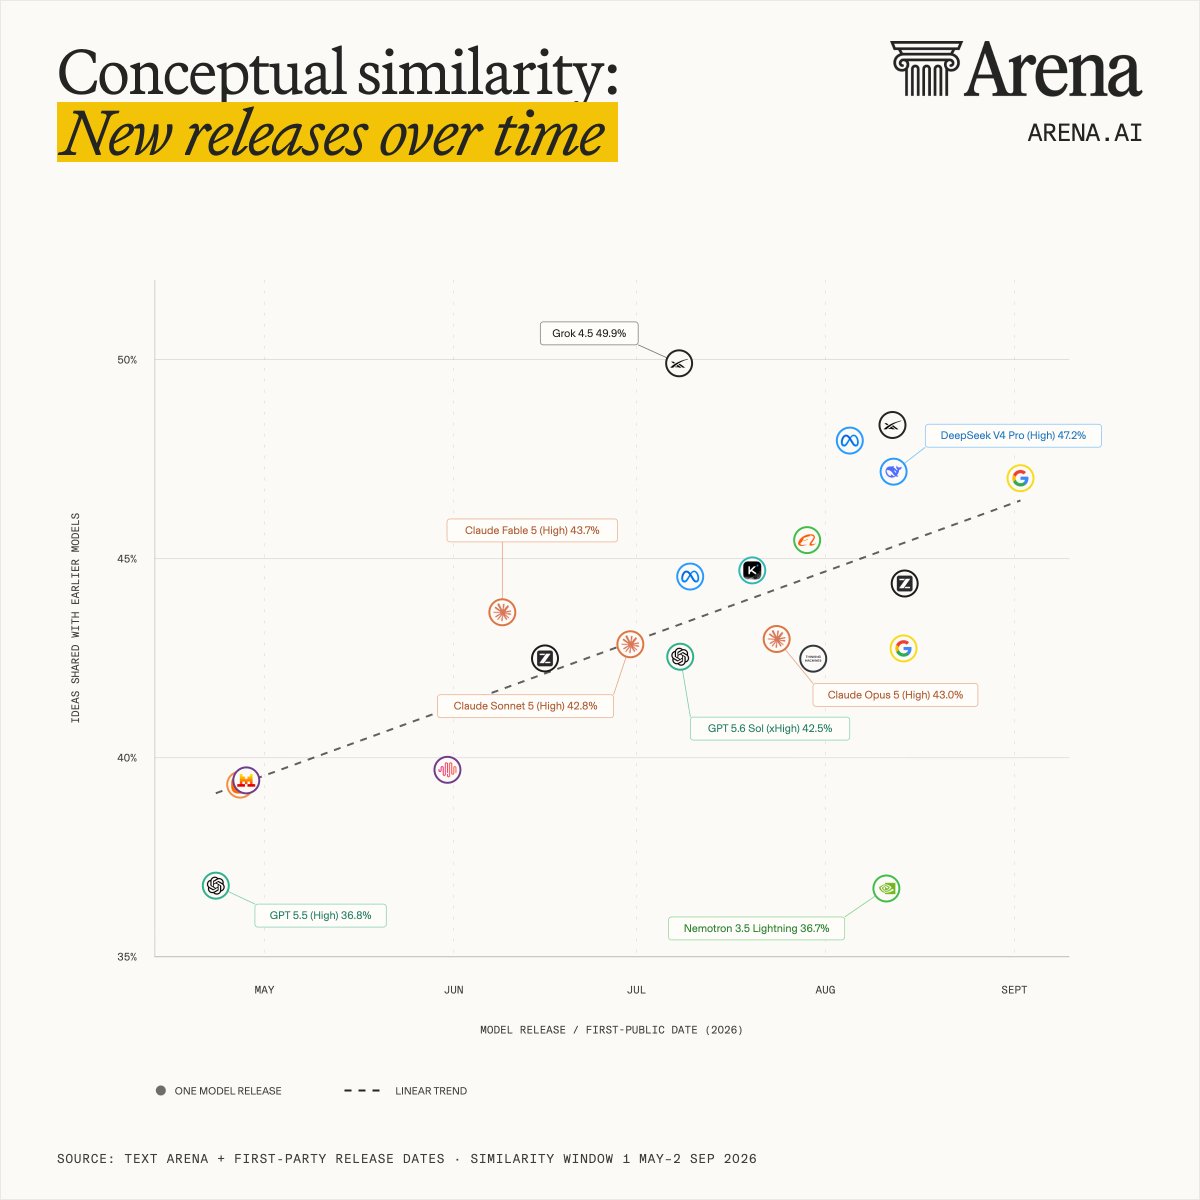
この種の類似性も増加している。各リリースを、バトルアリーナに登場した以前のモデルと比較すると、概念的重なりが大きくなっていることが分かる。たとえば、Muse Spark 1.2(xHigh)は、Muse Spark 1.1よりも以前のモデルとの概念的重なりが大きかった。48%対45%である。
全体像はまた、ワイルドカード的な応答の可能性が低下していることを示唆しており、次世代の低コストモデルは堅牢性の基準をさらに高める可能性が高い。
一方で、「平均への回帰」が問題となるシナリオもある。たとえば、複数のエージェントと本の章についてブレインストーミングする場合や、新しい地域市場でシリアルブランドを販売する革新的な方法を探す場合である。
創造的作業は第二の視点から最も多くを得る
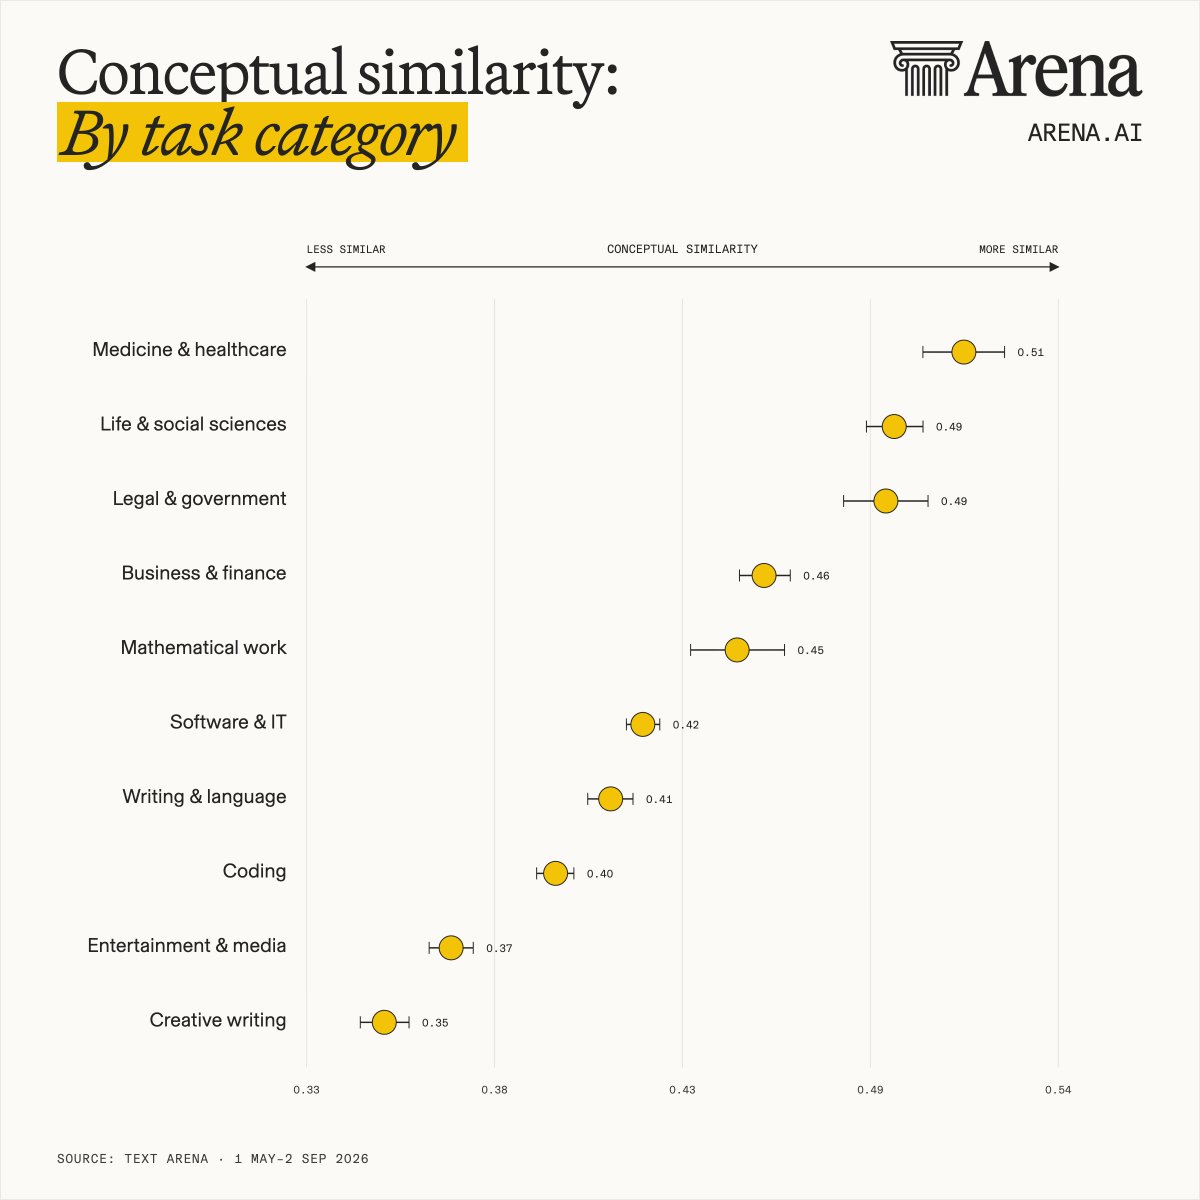
幸いなことに、タスクの種類はモデルの重なりを大幅に変え、しかもアイデアの探索と活用の両方に対応する方向に変える。
医学・医療が最も似た回答を生み、51.1%だった。次いで生命科学・社会科学が49.1%、法律・政府が48.9%だった。反対の端では、創造的ライティングが最も似ていない回答を生み、34.9%だった。エンターテインメント・メディアが36.8%、コーディングが39.7%と続いた。
制約の多いタスクは事実や手順の範囲が狭くなる傾向があるため、モデルは収斂した。反対に、自由回答型のタスクではモデルが独自の枠組みや例を選ぶ余地が大きく、回答間の多様性ははるかに高かった。
より多く支払ってもより良いブレインストーミングにはつながらない
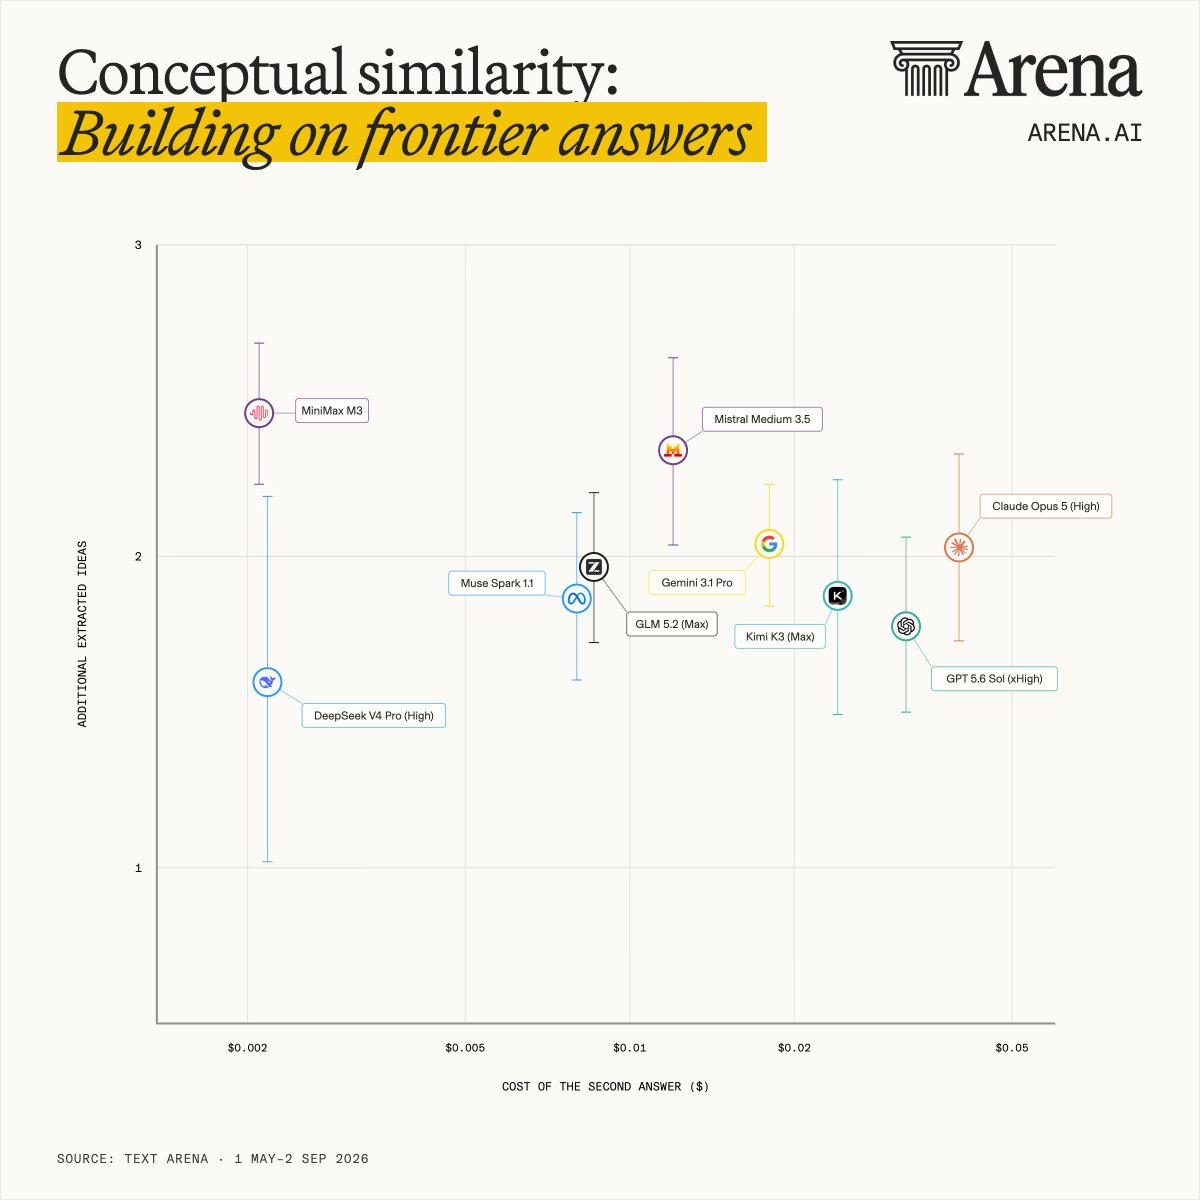
活用よりも探索が鍵だとしたらどうか。データは、最先端モデルが強固な基盤を提供した後、別のSOTAモデルを使ってそれを拡張しても、見返りは乏しいことを示唆している。
たとえば、Fable 5の回答が利用可能な場合、MiniMax M3を使うとOpus 5を立ち上げるよりも多くのアイデアが得られた。同様に、Mistral Medium 3.5の回答を組み合わせれば、GPT 5.6 Solを使うよりも1ドルあたり多くのアイデアが得られただろう。
このことの限界の1つは、アイデアの質が等しいとは限らないことだ。しかし、人間の専門家がレビューすれば、その多様性はより多くの水平思考を促す可能性が高く、それは最終的に創造的タスクで必要とされる。最適には、最先端モデルはより小さく、それでも堅牢なLLMと組み合わせられるだろう。
方法論
データ
分析は2026年5月1日から9月2日に記録された30,086件のテキストアリーナ比較を対象とする。英語のプロンプトに焦点を当て、バトルおよびダイレクトバトルのやり取りを含む。
アプローチ
LLMを審査員として用い、各モデルの回答から最大5つの裏付けられた主要アイデアを抽出した。2回目の審査パスでは、両方の元の回答と統合されたアイデアをレビューし、すべてのアイデアを、両モデルが共有、Aのみに存在、Bのみに存在のいずれかに分類した。完全な判定は、順序効果を減らすためにモデルの順序を逆にして繰り返した。それらの判定の平均値がこの分析の基礎を成す。
各比較について:
概念的類似度 = 共有アイデア / (共有 + Aのみ + Bのみのアイデア)
スコア1は、裏付けられたすべてのアイデアが共有されたことを意味し、スコア0は1つも共有されなかったことを意味する。
重なりが何を意味するかを示す2つの実例
・オンライン記事の執筆
あるユーザーが、MacBookでフォルダを解凍する方法についてSEO最適化された記事を依頼した。DeepSeek V4 Pro HighとFable 5 Highは、類似した構成を含め、緊密に一致した回答を生成した。両者のわずかな違いは限定的だった。DeepSeekはmacOSが一部のアーカイブ形式をネイティブにサポートしていない点を指摘し、Fableはファイル破損などの失敗事例を強調した。
概念的類似度スコアは0.833だった。2番目の回答は主に1番目を検証するものだった。
・人事ポリシーのメール作成
あるユーザーが、人事の医療ポリシー変更を伝えるメールを依頼した。Opus 5 Highは、登録された家族、有給休暇の保護、メッセージ送信前に解決すべき問題のチェックリストについて論じた。GLM 5.3 Maxは代わりに、そのポリシーがすでに有給休暇中の従業員にどのように影響するかを提起した。
概念的類似度スコアは0.106だった。どちらの回答も他方を単純に繰り返してはいなかった。両者を合わせると、より広範なポリシーリスクが明らかになる。