作者:@DawidGalarowicz 與 @petergostev
Arena 的對戰模式(Battle Mode)讓我們能比較兩個模型回答同一則使用者提示詞的表現。這使我們不僅能衡量偏好,還能測量兩者共享多少概念範圍。
我們檢視了 2026 年 5 月 1 日至 9 月 2 日期間,Text Arena 真實世界提示詞中 30,086 組針對同一題目的 AI 回答。以下是我們對模型相似度的發現。
主要發現
• 不同的 LLM 涵蓋的面向不同。各模型之間僅共享 43.1% 的觀點。
• 同一模型家族的相鄰世代彼此呼應。Grok 4.5 與 Grok 4.6 共享 59.7% 的觀點,GPT 5.5 與 GPT 5.6 則共享 59.2%。
• 美國與中國模型取材自相同的觀點。Fable 5 與 GLM 5.3 共享 55.9% 的論點,而 GLM、Kimi、Opus 與 Sonnet 則形成一個重疊度較高的鄰近群落。
• 支付更高的 token 價格並不能買到不同的視角。Fable 5 與 DeepSeek V4 Pro 的價格相差 12 倍,卻共享 59.2% 的觀點。
• 模型的思考方式正在趨同。多數最新版本涵蓋相同觀點的頻率,似乎高於先前的版本。
模型輸出的差異比你想像的更大
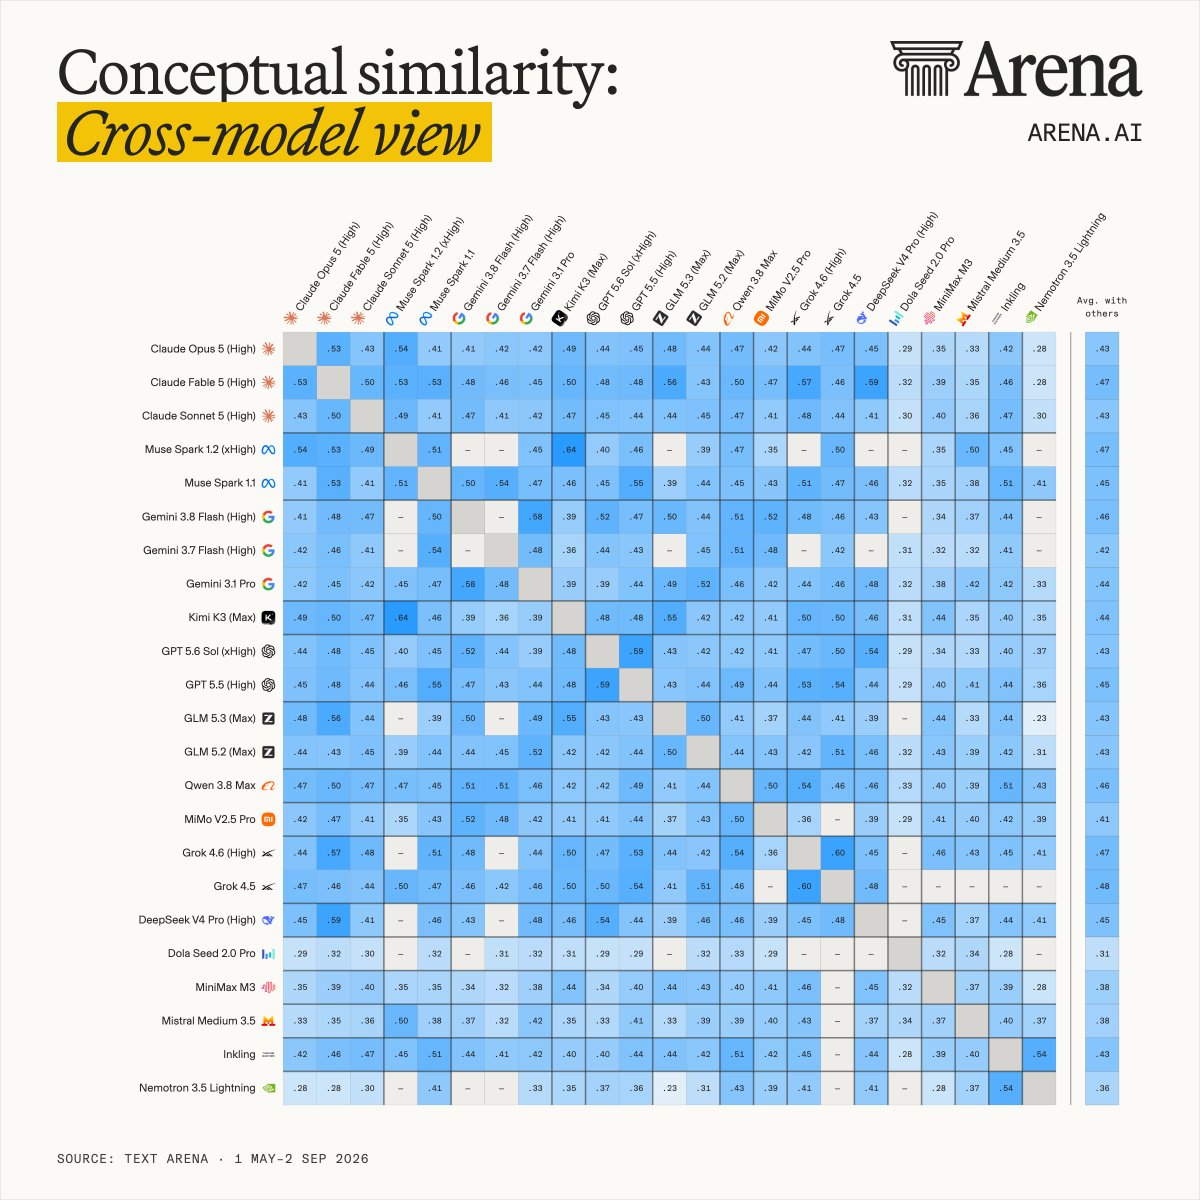
為了掌握模型回應內容的相似程度,我們定義了一項名為「概念相似度」的指標。這個方法把使用者與 AI 的互動濃縮成兩個不同 LLM 針對同一道問題所提出的五個重點,再估算兩者合計十個重點之間的重疊程度。
平均而言,一場對戰中辨識出的相異論點,大約每十個就有四個同時出現在兩方的回答裡。儘管前沿模型採用相似的訓練配方,我們仍可觀察到它們經常從可選的觀點中挑選不同的子集。
舉例來說,被問到鬆餅食譜時,兩個模型可能涵蓋相同的步驟,但第一個決定推薦配料,另一個則可能補充該避免的錯誤。
這種差異在同一家族的相鄰世代之間會縮小——它們往往只能提供有限的第二意見。Grok 4.5 與 Grok 4.6 共享 59.7% 的觀點,GPT 5.5 與 GPT 5.6 則共享 59.2%。當目標是驗證時,這類配對或許有用,但它們提供的概念廣度相對較小。
觀察到的最高重疊度出現在 Kimi K3 與 Muse Spark 1.2 之間,達 63.5%。另一端的極端例子是字節跳動(Bytedance)的 Dola Seed 2.0 Pro,它在各組配對中平均僅約 31.1%,差異化程度特別高。
美國與中國模型思路相近
既然同一實驗室發布的模型之間關係更為密切,我們或許也會預期美國境內發布的模型,彼此之間的關聯比境外模型更強。
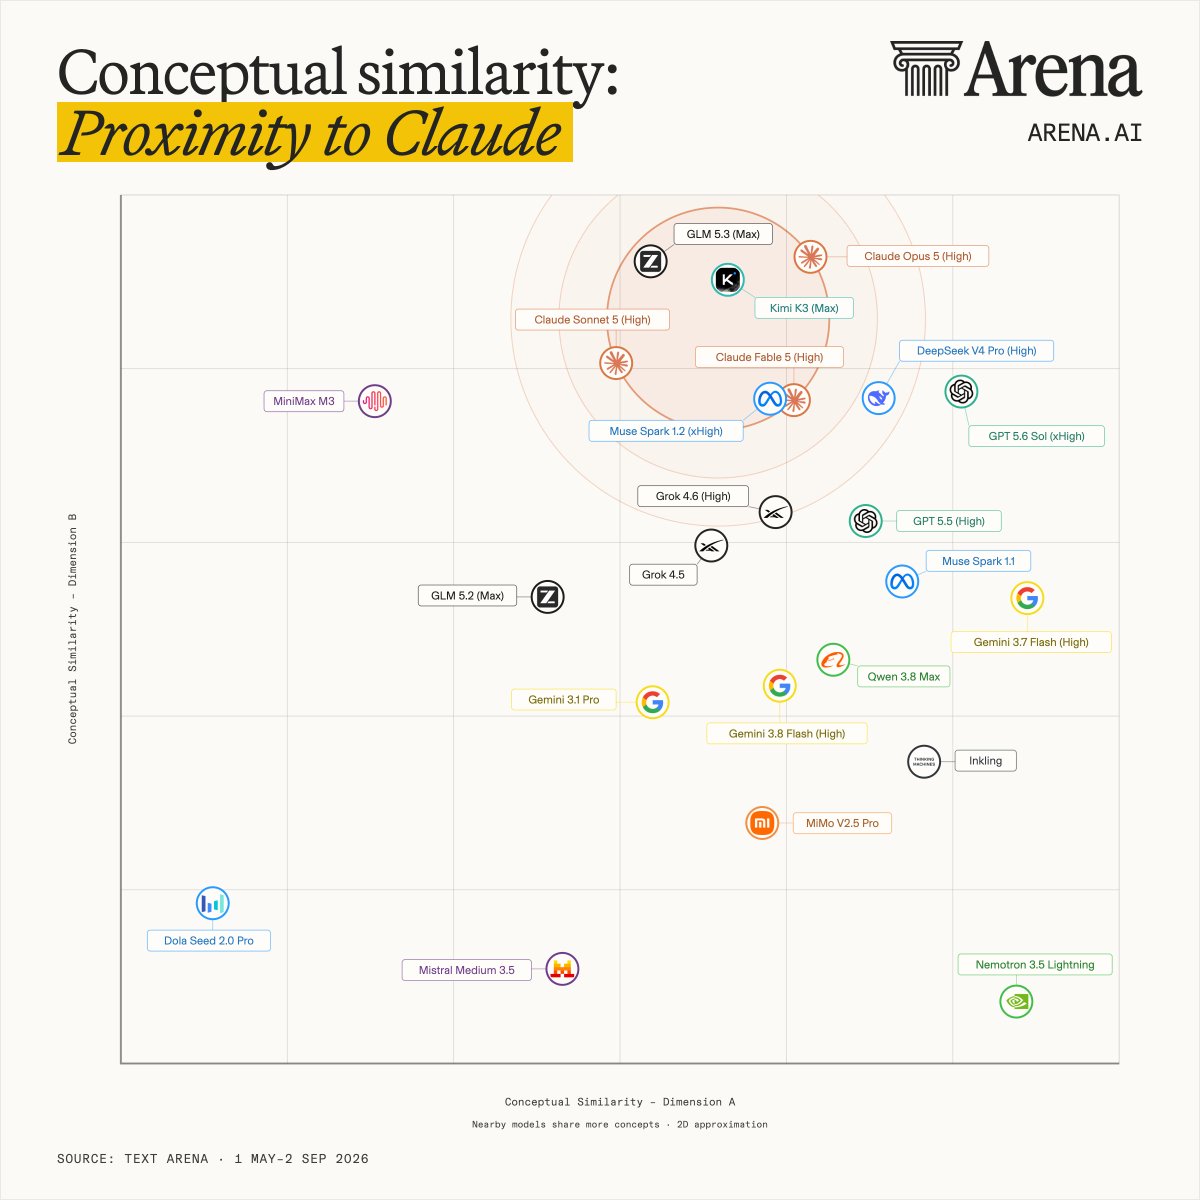
然而事實證明,模型的相似度是跨國界的。GLM、Kimi、Opus 與 Sonnet 佔據同一個重疊度較高的鄰近區域,而不是形成彼此孤立的美國與中國陣營。當把與三個 Claude 模型的重疊情形疊加起來看時,這一點尤其明顯。
雖然具體原因難以確切指出,但前沿模型之間的概念相似性,可能單純源自它們共享核心訓練素材,以及近期跨實驗室的共同關注焦點。
模型之間的重疊正在增加
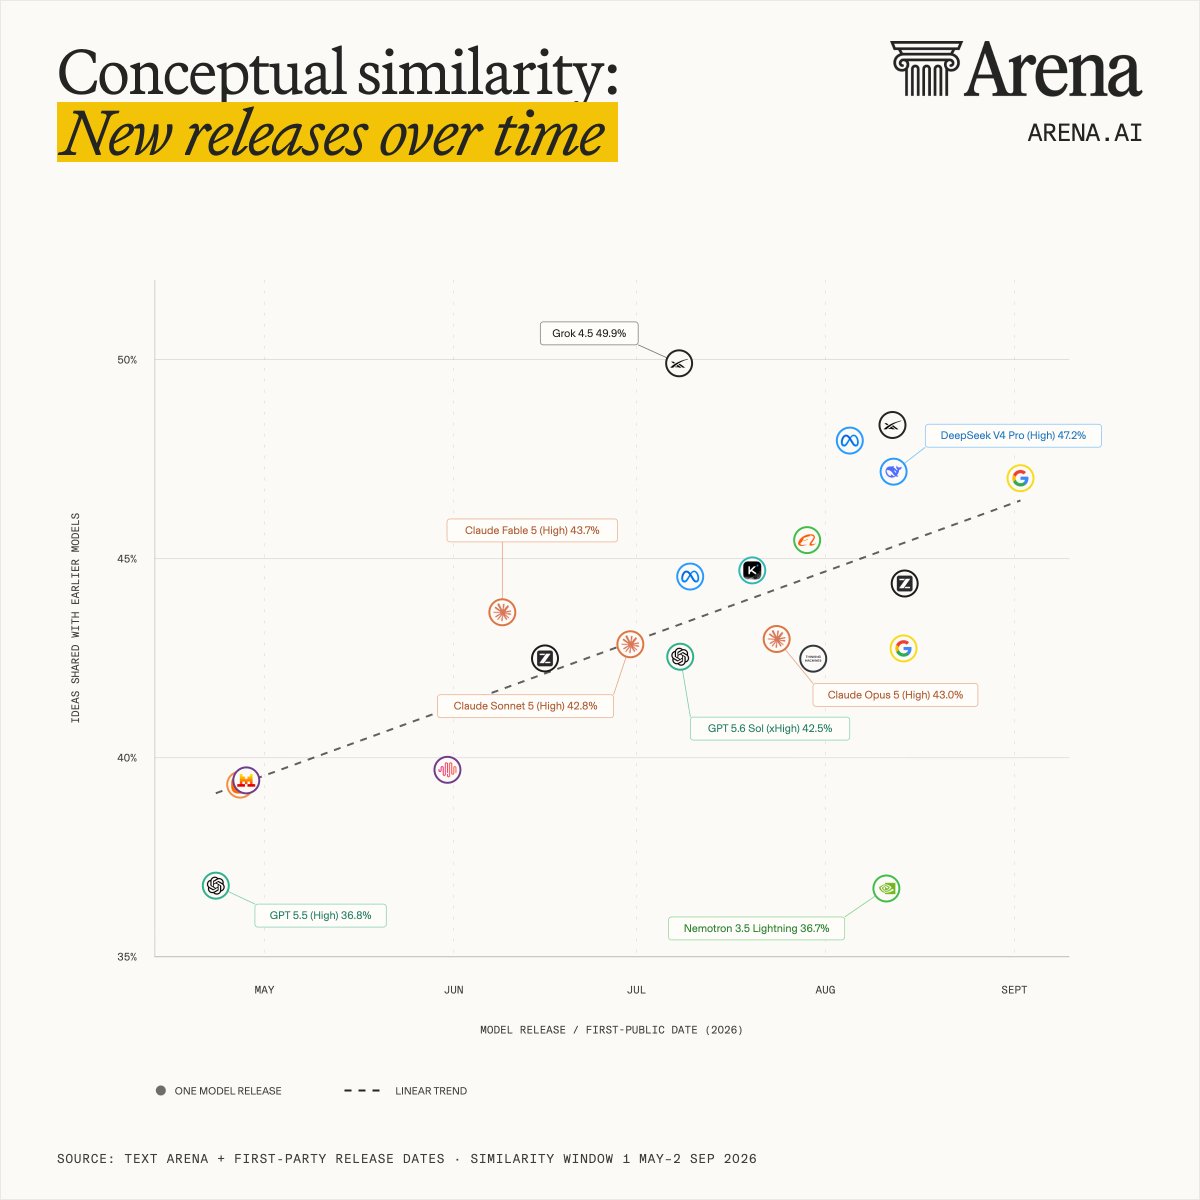
這類相似度也正在上升。把每個新版本與曾在對戰競技場出現過的舊模型相比,可以看出概念重疊已經增加。例如,Muse Spark 1.2(xHigh)與早期模型的概念重疊度高於 Muse Spark 1.1——分別是 48% 對上 45%。
整體趨勢也顯示,出現「意料之外」回答的機率可能正在下降,而下一代的低成本模型很可能會把穩定性的標準再往上推。
另一方面,在某些情境下「回歸平均」反而可能是個問題。例如,與一組 AI 代理人一起腦力激盪一個書本章節,或是為某個麥片品牌在新市場尋找創新的行銷方式。
創意工作最能從第二種視角獲益
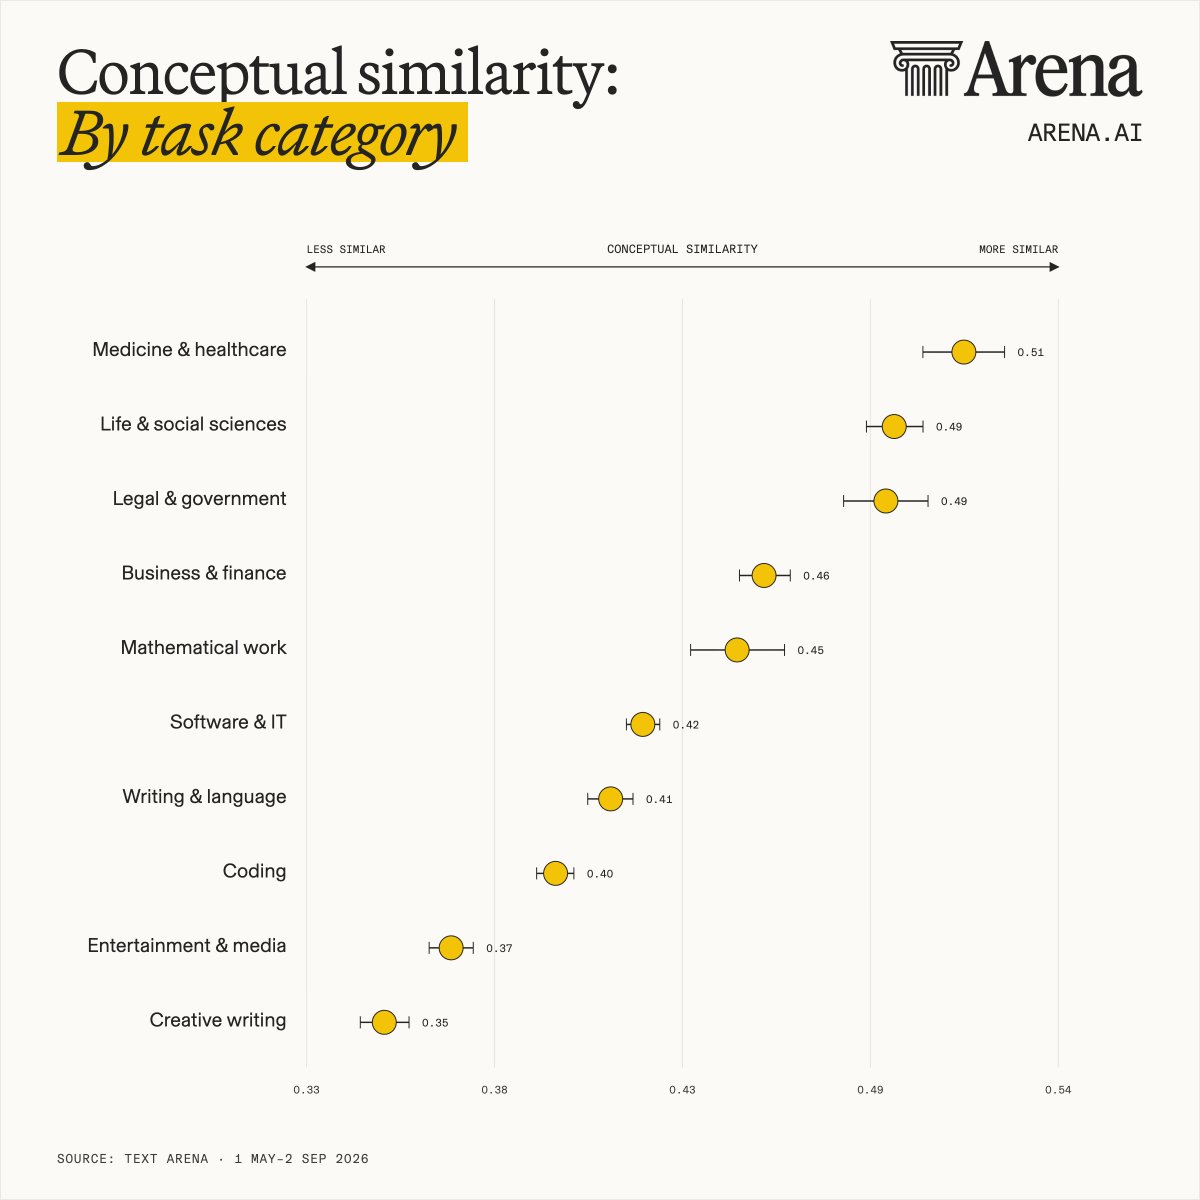
幸運的是,任務類型會大幅改變模型之間的重疊程度,而且方向正好能同時容納觀點的探索與運用。
醫療與健康照護領域產生的答案最為相似,達 51.1%,其次是生命與社會科學的 49.1%,以及法律與政府的 48.9%。另一端則是創意寫作,答案相似度最低,僅 34.9%;娛樂與媒體以 36.8% 緊追在後,程式設計則為 39.7%。
由於受限型任務通常只涉及較窄的事實或流程範圍,模型自然會趨於一致。反過來說,開放式任務讓模型有更多空間選擇自己的切入框架與例子,答案之間的多樣性也就高得多。
付更多錢不等於有更好的腦力激盪
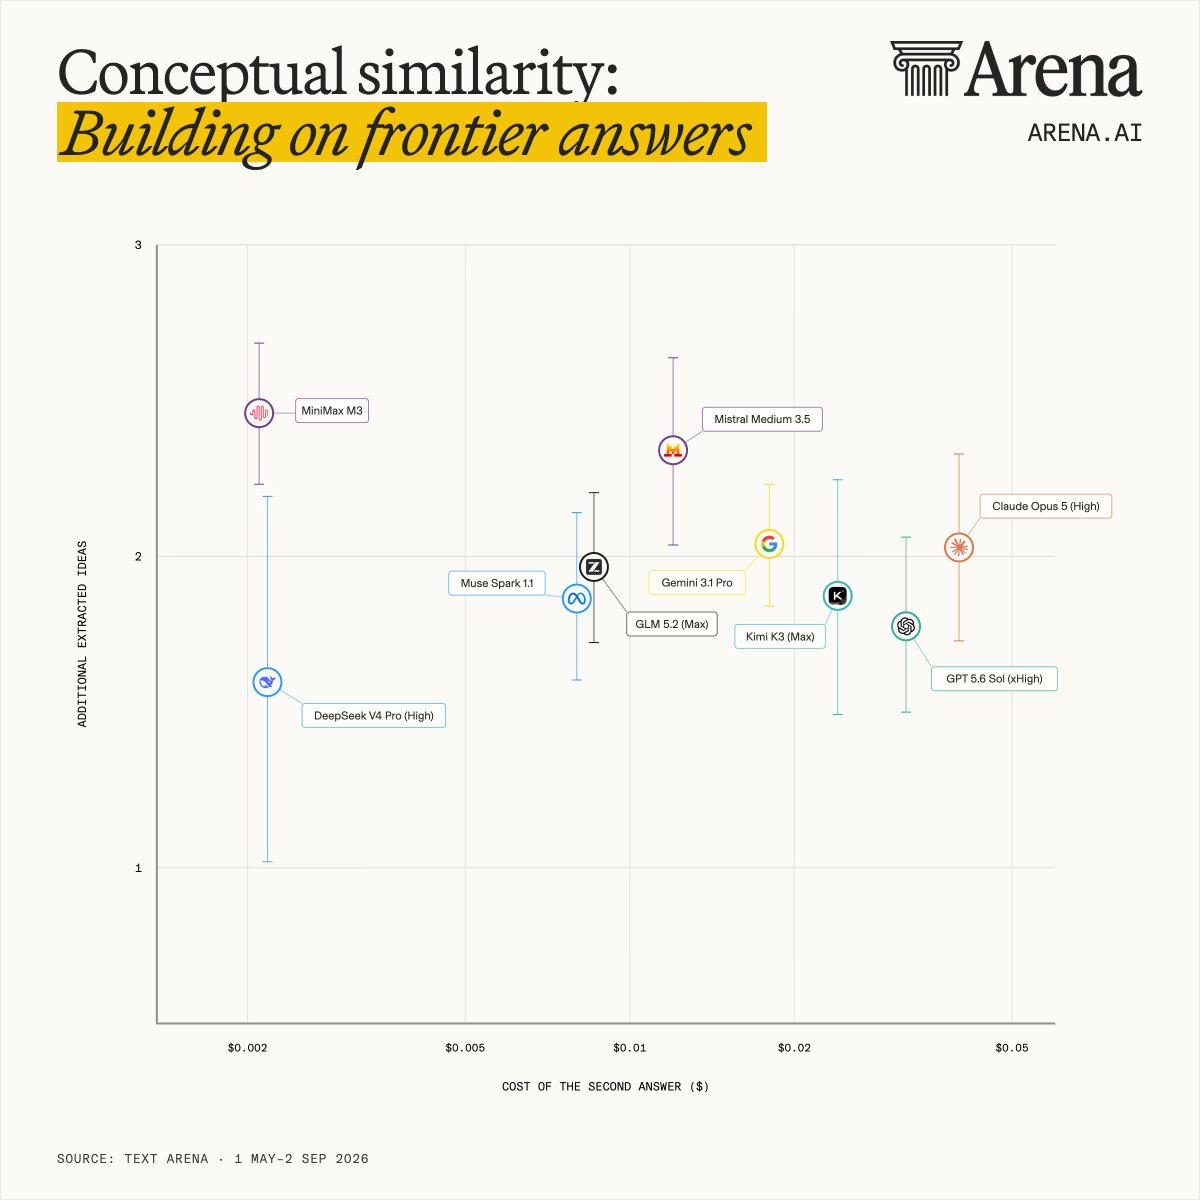
如果關鍵在於探索而非運用呢?數據顯示,一旦某個前沿模型已打下紮實基礎,再動用另一個 SOTA 模型來延伸,投資報酬率並不好。
舉例來說,在已有 Fable 5 答案的情況下,使用 MiniMax M3 能帶來比啟動 Opus 5 更多的觀點。同樣地,搭配 Mistral Medium 3.5 的答案,每一塊錢能換到的觀點也會比使用 GPT 5.6 Sol 更多。
這麼做的一項限制是,這些觀點的品質未必相同。不過,一旦經過人類專家審視,它們的多樣性很可能激發更多水平思考,而這正是創意任務最終所需要的。最理想的做法,是讓前沿模型搭配一個規模較小但依然穩健的 LLM。
研究方法
資料
本分析涵蓋 2026 年 5 月 1 日至 9 月 2 日期間記錄的 30,086 組 Text Arena 比較。分析聚焦於英語提示詞,並包含 Battle 與 Direct Battle 兩種互動模式。
方法
我們以「LLM 即評審」的方式,從每個模型的回答中擷取最多五個有依據的重點。第二輪評審則同時檢視兩份原始回答與合併後的重點,將每個重點歸類為兩模型共享、僅出現於 A,或僅出現於 B。整個評判流程會把模型順序對調後再重複一次,以降低順序效應。這些評判的平均值即構成本次分析的基礎。
每一組比較的計算方式為:概念相似度 = 共享觀點 ÷(共享 + 僅 A + 僅 B 的觀點)
分數為 1 代表所有有依據的觀點都共享;分數為 0 則代表完全沒有共享。
兩個真實案例說明重疊的意義
• 撰寫一篇線上文章
一位使用者要求撰寫一篇關於在 MacBook 上解壓縮資料夾的 SEO 優化文章。DeepSeek V4 Pro High 與 Fable 5 High 產出的回答高度一致,連結構都很相似。兩者少數的差異相當細微:DeepSeek 提到 macOS 原生不支援某些壓縮格式,Fable 則強調檔案毀損等失敗情況。
概念相似度分數為 0.833。第二個回答大致上只是驗證了第一個。
• 草擬一封人資政策通知信
使用者要求寫一封通知人資醫療政策變更的電子郵件。Opus 5 High 談到已登記的家庭成員、PTO(支薪休假)保障,以及發信前應先解決的問題清單。GLM 5.3 Max 則提出該政策可能如何影響已經在休 PTO 的員工。
概念相似度分數為 0.106。兩個回答都沒有只是重複對方。合起來看,它們揭露了更廣泛的政策風險。